
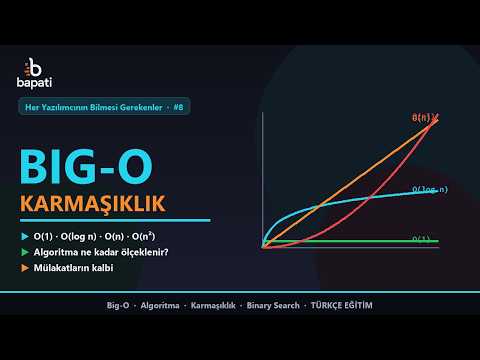
Big-O gösterimi nedir, bir algoritmanın performansı nasıl değerlendirilir? Karmaşıklık sınıflarını gerçek kod örnekleriyle açıklıyoruz.
Big-O Ne Söyler, Ne Söylemez?
Big-O gösterimi bir kodun kaç saniye süreceğini söylemez. Söylediği şey, veri miktarı arttıkça çalışma süresinin nasıl büyüyeceğidir.
Bu ayrım önemlidir: küçük veri kümelerinde O(n²) bir çözüm, O(n log n) bir çözümden daha hızlı çalışabilir. Fark, veri büyüdükçe ortaya çıkar. Yani Big-O bir ölçüm değil, bir eğilim tahminidir. Doğru soru "şu an ne kadar sürüyor" değil, "veri on kat artarsa ne olur" sorusudur.
Aynı işi yapan beş farklı yaklaşımın, veri büyüdükçe nereye gittiğini tek tabloda görmek meseleyi kapatır:
| Karmaşıklık | n = 10 | n = 1.000 | n = 1.000.000 | Tipik örnek |
|---|---|---|---|---|
| O(1) | 1 | 1 | 1 | Sözlükten anahtarla okuma |
| O(log n) | 3 | 10 | 20 | İkili arama, index taraması |
| O(n) | 10 | 1.000 | 1.000.000 | Listeyi bir kez dolaşmak |
| O(n log n) | 33 | 10.000 | 20.000.000 | Verimli sıralama |
| O(n²) | 100 | 1.000.000 | 1.000.000.000.000 | İç içe iki döngü |
Son satıra dikkat edin: bir milyon kayıtta O(n²), O(n)'e göre bir milyon kat daha fazla iş yapar. Bu, "biraz yavaş" değil "hiç bitmiyor" demektir.
O(1): Veri Ne Kadar Büyürse Büyüsün
Sabit zamanlı işlemler, veri miktarından etkilenmez. Bir dizinin belirli bir indisindeki elemana erişmek buna örnektir. Hash tabanlı yapılarda anahtarla arama da ortalama durumda O(1) kabul edilir; sözlük ve küme yapılarını bu kadar kullanışlı yapan özellik budur.
# n ne olursa olsun tek adım
kullanicilar = {"a1": "Ayşe", "b2": "Mehmet", "c3": "Zeynep"}
ad = kullanicilar["b2"]        # O(1)

liste = ["Ayşe", "Mehmet", "Zeynep"]
ad = liste[1]                  # O(1)
"Ortalama durumda" ifadesi önemli: hash çakışması yoğunlaşırsa bu erişim kötü senaryoda O(n)'e kadar düşebilir. Pratikte standart kütüphanelerin sözlük uygulamaları bunu sizin yerinize yönetir, ama kendi hash fonksiyonunuzu yazıyorsanız akılda tutulmalıdır.
O(log n): Her Adımda Yarıya Bölmek
Logaritmik karmaşıklık, her adımda arama alanını ikiye bölen algoritmalarda karşımıza çıkar. İkili arama klasik örnektir.
def ikili_arama(sirali_dizi, hedef):
    """Ön koşul: dizi SIRALI olmalı. Sıralı değilse sonuç anlamsızdır."""
    alt, ust = 0, len(sirali_dizi) - 1
    adim = 0
    while alt <= ust:
        adim += 1
        orta = (alt + ust) // 2          # her turda alan yarıya iner
        if sirali_dizi[orta] == hedef:
            return orta, adim
        if sirali_dizi[orta] < hedef:
            alt = orta + 1
        else:
            ust = orta - 1
    return -1, adim

dizi = list(range(1_000_000))
print(ikili_arama(dizi, 999_999))   # (999999, 20) — bir milyon eleman, 20 adım
Bir milyon elemanlı sıralı bir dizide aranan değeri bulmak yaklaşık yirmi adım sürer. Aynı işi baştan sona tarayarak yapmak bir milyon adım demektir. Veritabanı index'lerinin sorguları hızlandırmasının arkasındaki mantık da budur — ve aynı sebeple index'siz bir sütunda arama, tablo büyüdükçe doğrusal olarak yavaşlar.
O(n): Doğrusal Artış
Bir koleksiyonu baştan sona bir kez dolaşan her işlem doğrusaldır. Veri iki katına çıktığında süre de yaklaşık iki katına çıkar. Çoğu günlük işlem bu sınıfa girer ve pratikte gayet kabul edilebilirdir.
Dikkat edilmesi gereken nokta, doğrusal bir işlemin başka bir doğrusal işlemin içine yerleştirilmesidir; o noktada karmaşıklık sessizce kareselleşir. Ve bu, çoğu zaman iç içe iki for gibi görünmez:
# Görünürde tek döngü — ama içindeki `in` araması listede O(n)
def ortak_olanlar(a, b):
    return [x for x in a if x in b]      # O(n × m) — gizli kareselleşme

# Aynı iş, küme ile: `in` araması O(1)'e iner
def ortak_olanlar_hizli(a, b):
    b_kume = set(b)                      # O(m), bir kez
    return [x for x in a if x in b_kume] # O(n)
İki liste de 10.000 elemanlıysa üstteki 100 milyon karşılaştırma yapar, alttaki 20 bin. Kod neredeyse aynı görünür; fark yalnızca bir set() çağrısıdır.
O(n²): Sessiz Performans Katili
İç içe iki döngü, çoğu zaman farkında olmadan yazılır. Bin elemanlı bir liste için bu bir milyon işlem demektir; on bin eleman için yüz milyon. Uygulamanın test ortamında sorunsuz çalışıp üretimde yavaşlamasının en yaygın nedeni budur: test verisi küçüktür, gerçek veri değildir.
Aynı tuzağın en pahalı hâli veritabanında görülür ve adı N+1 sorgu problemidir:
// YANLIŞ: 1 sorgu liste için, her sipariş için 1 sorgu daha
var siparisler = db.Siparisler.ToList();          // 1 sorgu
foreach (var s in siparisler)
    Console.WriteLine(s.Musteri.Ad);              // her turda ayrı sorgu!
// 1.000 sipariş -> 1.001 veritabanı gidiş dönüşü

// DOĞRU: ilişkili veriyi tek seferde getir
var siparisler = db.Siparisler
                   .Include(s => s.Musteri)
                   .ToList();                      // 1 sorgu
foreach (var s in siparisler)
    Console.WriteLine(s.Musteri.Ad);               // ek sorgu yok
Buradaki maliyet CPU değil ağ gecikmesidir. Her sorgu 2 ms sürse bile 1.000 sorgu 2 saniye eder; sayfa açılmaz. Çözüm genellikle iç döngüyü bir sözlük araması ya da tek bir toplu sorgu ile değiştirmektir.
Bellek de Bir Karmaşıklıktır
Big-O yalnızca süre için değil, bellek için de kullanılır. Bazen ikisi arasında bilinçli bir takas yaparsınız: yukarıdaki set(b) örneği O(m) ek bellek harcayarak süreyi O(n×m)'den O(n)'e indirir.
| Yaklaşım | Süre | Ek bellek | Ne zaman |
|---|---|---|---|
| Doğrudan tarama | O(n×m) | O(1) | Veri küçük, bellek kısıtlı |
| Küme/sözlük kurma | O(n+m) | O(m) | Veri büyük — varsayılan tercih |
| Önce sıralayıp ikili arama | O(m log m + n log m) | O(1) | Sıralı erişim de gerekiyorsa |
Bir milyonluk veride "biraz bellek harcayıp çok zaman kazanmak" neredeyse her zaman doğru taraftır; bunun istisnası gömülü sistemler gibi belleğin gerçekten kıt olduğu ortamlardır.
Amortize Edilmiş Karmaşıklık: Ortalama Değil, Yayılmış
Bazı işlemler çoğu zaman ucuzdur ama arada bir pahalıya patlar. Dinamik dizinin sonuna eleman eklemek buna örnektir: yer varken O(1)'dir, dolduğunda tüm dizi daha büyük bir alana kopyalanır ve o tek işlem O(n) olur.
Buna rağmen listeye ekleme "O(1) amortize" sayılır. Sebebi şu: kapasite her seferinde ikiye katlandığı için pahalı kopyalama giderek seyrekleşir; n ekleme işleminin toplam maliyeti O(n)'de kalır, yani ekleme başına ortalama sabit.
| İşlem | Tipik durum | Kötü durum | Amortize |
|---|---|---|---|
| Listeye sona ekleme | O(1) | O(n) — yeniden boyutlandırma | O(1) |
| Sözlüğe ekleme | O(1) | O(n) — yeniden hash'leme | O(1) |
| Listenin başına ekleme | O(n) | O(n) | O(n) |
Bu ayrım gerçek zamanlı sistemlerde önemlidir: amortize O(1) "her işlem hızlı" demek değil, "uzun vadede ortalama hızlı" demektir. Her isteğin sabit sürede bitmesi gereken bir yerde, o arada bir gelen O(n) tırmanışı gecikme grafiğinde diken olarak görünür.
Bilinen bir boyut varsa kapasiteyi baştan ayırmak bu dikenleri tamamen ortadan kaldırır:
// 100.000 elemanlık büyümede ~17 kez yeniden boyutlandırma yapar
var liste = new List<int>();

// Kapasite baştan ayrıldı: hiç yeniden boyutlandırma yok
var liste = new List<int>(100_000);
Doğru Veri Yapısı, Yarısı Çözülmüş Problem
Karmaşıklık çoğu zaman algoritmadan değil, seçilen veri yapısından gelir. Listede arama yapmak doğrusaldır; sözlükte arama yapmak sabittir.
| İşlem | Liste / Dizi | Sözlük (hash) | Küme |
|---|---|---|---|
| İndisle erişim | O(1) | — | — |
| Değer arama | O(n) | O(1) | O(1) |
| Sona ekleme | O(1) | O(1) | O(1) |
| Başa ekleme | O(n) | — | — |
| Silme (değere göre) | O(n) | O(1) | O(1) |
| Sıra korunur mu | Evet | Ekleme sırası | Hayır |
Sık arama yapacaksanız sözlük, sıralı erişim gerekiyorsa liste, benzersizlik gerekiyorsa küme uygun seçimdir. Bu seçimleri baştan doğru yapmak, sonradan yapılacak optimizasyon çalışmalarının çoğunu gereksiz kılar.
Ne Zaman Önemsemeli?
Her kod parçası için karmaşıklık analizi yapmak gereksiz bir yüktür. Yüz elemanlık bir liste üzerinde O(n²) çalışmak kimseyi rahatsız etmez. Asıl dikkat edilmesi gereken yerler, veri miktarının zamanla büyüyeceği kısımlardır: kullanıcı listeleri, log kayıtları, sipariş geçmişi.
Pratik yaklaşım şudur: önce çalışan ve okunabilir kodu yaz, ölç, sonra yalnızca gerçekten darboğaz olan yeri iyileştir. Ölçmek de tahmin etmekten kolaydır:
import time

def sure_olc(fonksiyon, *args):
    bas = time.perf_counter()
    sonuc = fonksiyon(*args)
    return sonuc, (time.perf_counter() - bas) * 1000   # ms

# Aynı işi iki boyutta ölç: süre 10 kat mı, 100 kat mı arttı?
# 10 kat  -> O(n)      · sorun yok
# 100 kat -> O(n²)     · veri büyüdükçe patlayacak
Bu tek ölçüm, karmaşıklık analizi yapmadan da sınıfı size söyler: veriyi on katına çıkarın, süreye bakın. Süre on katına çıktıysa doğrusalsınız; yüz katına çıktıysa kareselsiniz ve o kod parçası er ya da geç sorun çıkaracaktır.
Daha fazlası: Big-O'yu görsel örneklerle anlattığımız bölüm, 'Her Yazılımcının Bilmesi Gerekenler' serimizin bir parçası; seride veri yapılarından eşzamanlılığa kadar 15 temel konu yer alıyor.
Videoyu sitemizde izle · YouTube'da aç · Kanala abone ol
Daha fazlası: Bilgisayarların içinde neler olup bittiğini anlattığımız video, performans konusuna farklı bir açıdan bakıyor.
Videoyu sitemizde izle · YouTube'da aç · Bapati kanalına abone ol