
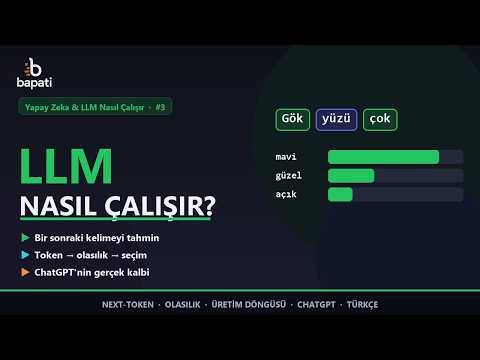
Büyük dil modelleri nasıl çalışır? Token, embedding, transformer ve attention kavramlarını matematiğe girmeden sade örneklerle açıklıyoruz.
Temel Fikir: Sıradaki Kelimeyi Tahmin Etmek
Büyük dil modellerinin yaptığı iş, dışarıdan göründüğü kadar karmaşık değildir: verilen metnin ardından hangi parçanın gelme olasılığının yüksek olduğunu tahmin ederler. Bu tahmini defalarca tekrarlayarak cümleler, paragraflar ve sayfalar üretirler.
Yani model bir cevabı baştan planlayıp yazmaz; parça parça ilerler. Her adımda elinde olan tek şey, o ana kadar yazılmış metindir.
"Türkiye'nin başkenti" ifadesinden sonra modelin gördüğü tablo kabaca şöyledir:
| Aday parça | Olasılık |
|---|---|
| Ankara | %94 |
| İstanbul | %3 |
| ise | %1 |
| diğer binlerce aday | %2 |
Model bu listeden birini seçer, seçtiğini metnin sonuna ekler ve aynı işlemi baştan yapar. Cevabın tamamı, bu tek adımın binlerce kez tekrarıdır. Modelin güçlü ve zayıf yanlarının çoğu doğrudan bu çalışma biçiminden kaynaklanır.
Seçimin ne kadar "cesur" olacağını temperature belirler: 0'a yakın değerlerde model hep en yüksek olasılıklı adayı seçer ve tekrara düşer; yüksek değerlerde çeşitlenir ama tutarlılığı azalır.
Token: Model Kelimeleri Değil Parçaları Görür
Model metni kelime kelime değil, token adı verilen parçalar hâlinde işler. Bir token bazen tam bir kelime, bazen kelimenin bir bölümü, bazen tek bir karakterdir.
Türkçe gibi eklemeli dillerde bu ayrım doğrudan cebinize dokunur. Aynı anlamı taşıyan iki cümlenin maliyeti eşit değildir:
| Metin | Karakter | Yaklaşık token | Karakter/token |
|---|---|---|---|
The capital of Turkey is Ankara. | 32 | ~7 | 4,6 |
Türkiye'nin başkenti Ankara'dır. | 31 | ~14 | 2,2 |
kararlaştırılamamışlardan | 25 | ~11 | 2,3 |
Aynı içerik Türkçede kabaca iki katı token tüketir. Ücretlendirme ve bağlam sınırı token üzerinden hesaplandığı için, Türkçe bir uygulamada aynı bütçeyle yarı kadar metin işlersiniz. Bu, tasarım aşamasında hesaba katılması gereken somut bir kısıttır.
# Tahmin etmek yerine ölçmek: token sayısını doğrudan saymak
import tiktoken

kodlayici = tiktoken.get_encoding("cl100k_base")

for metin in ["The capital of Turkey is Ankara.",
              "Türkiye'nin başkenti Ankara'dır."]:
    parcalar = kodlayici.encode(metin)
    print(f"{len(parcalar):3} token | {metin}")
    print("      ", [kodlayici.decode([p]) for p in parcalar])
Bu ayrıntı bir yan etki daha üretir: model kelimeyi bütün olarak görmediği için harf saymak, kelimeyi tersten yazmak ya da kafiye bulmak gibi işlerde beklenmedik biçimde zorlanır. Sorun zekâ değil, girdiyi hiç o çözünürlükte görmemesidir.
Embedding: Anlamı Sayıya Çevirmek
Model sayılarla çalışır; dolayısıyla her token bir sayı vektörüne dönüştürülür. Bu vektörlere embedding denir ve tipik olarak yüzlerce ya da binlerce boyutu vardır.
Embedding'lerin değerli tarafı, benzer anlamdaki ifadelerin bu sayı uzayında birbirine yakın düşmesidir. "Doktor" ile "hemşire" arasındaki mesafe, "doktor" ile "traktör" arasındakinden kısadır — üstelik ikinci çift yazım olarak birbirine daha çok benzemesine rağmen.
// İki metnin anlamca yakınlığı: kosinüs benzerliği
function kosinusBenzerligi(a, b) {
    let carpim = 0, normA = 0, normB = 0
    for (let i = 0; i < a.length; i++) {
        carpim += a[i] * b[i]
        normA  += a[i] * a[i]
        normB  += b[i] * b[i]
    }
    return carpim / (Math.sqrt(normA) * Math.sqrt(normB))
}

// 1'e yakın: aynı şeyden bahsediyorlar
// 0'a yakın: ilgisiz
// Arama motorunuzun "anlamca en yakın 5 belge" sorgusu tam olarak budur.
Bu özellik, arama ve benzerlik bulma gibi işlerin temelini oluşturur; aşağıda değineceğimiz RAG mimarilerinin çalışma mantığı da buna dayanır. Kelime eşleşmesine dayalı klasik aramanın kaçırdığı "zam" ↔ "ücret artışı" ilişkisini embedding yakalar.
Attention: Hangi Kelimeye Ne Kadar Bakmalı?
Bir cümleyi anlamak için her kelimeye eşit ağırlık vermek yanlış sonuç üretir. "Çantayı masaya koydum çünkü ağırdı" cümlesinde "ağırdı" kelimesinin neyi nitelediğini bulmak gerekir — çanta mı, masa mı? İnsan bunu bağlamdan çözer; modelin de bir mekanizmaya ihtiyacı vardır.
Attention mekanizması tam olarak bunu yapar: her token üretilirken, girdideki diğer token'lara ne kadar dikkat edileceğini hesaplar. "Ağırdı" işlenirken ağırlığın büyük kısmı "çantayı" üzerine düşer.
Transformer mimarisinin dil işlemede önceki yaklaşımları geride bırakmasının temel sebebi budur. Ancak bir bedeli vardır: attention, her token'ı diğer tüm token'larla karşılaştırır.
| Bağlam uzunluğu | Karşılaştırma sayısı | Göreli maliyet |
|---|---|---|
| 1.000 token | 1 milyon | 1× |
| 10.000 token | 100 milyon | 100× |
| 100.000 token | 10 milyar | 10.000× |
Bağlamı iki katına çıkarmak maliyeti iki değil dört katına çıkarır. "Tüm belgeleri prompt'a koyalım" fikrinin neden hızla pahalılaştığı buradan anlaşılır.
Eğitim: Pretraining, Fine-tuning ve RLHF
Model önce çok büyük miktarda metin üzerinde genel dil yeteneği kazanır; bu aşamaya pretraining denir ve maliyetin neredeyse tamamı buradadır.
| Aşama | Ne öğretir | Veri ölçeği | Kim yapar |
|---|---|---|---|
| Pretraining | Dilin genel yapısı ve dünya bilgisi | Trilyonlarca token | Model sağlayıcısı |
| Fine-tuning | Belirli görev, biçim ya da üslup | Binlerce örnek | Sağlayıcı ya da siz |
| RLHF | Hangi cevabın tercih edildiği | İnsan karşılaştırmaları | Model sağlayıcısı |
Modelin "yardımcı ve zararsız" cevaplar vermeye yönelmesi büyük ölçüde RLHF aşamasının ürünüdür. Aynı aşama, modelin bazen fazla temkinli davranmasının da sebebidir.
Pratikte sık karıştırılan bir nokta: fine-tuning modele yeni bilgi öğretmenin verimli yolu değildir. Kurum belgelerinizi modele "öğretmek" istiyorsanız, doğru araç genellikle fine-tuning değil RAG'dır. Fine-tuning biçimi ve üslubu öğretir; güncel bilgiyi değil.
Neden Uydurur? Halüsinasyon Meselesi
Model doğruluk değil olasılık optimize eder. Bilmediği bir konuda da istatistiksel olarak makul görünen bir cevap üretir; bu cevabın gerçekle örtüşme garantisi yoktur.
Halüsinasyon bir arıza değil, çalışma biçiminin doğal sonucudur. Model "bilmiyorum" demek için de bir sebep görmelidir; varsayılan davranışı, en olası devamı yazmaktır.
| Risk yüksek | Risk düşük |
|---|---|
| Tarihler, sayılar, istatistikler | Metni özetlemek |
| Kaynak, makale, kitap adı | Üslup ve biçim değiştirmek |
| Kişiye özel ve nadir bilgiler | Verilen metinden soru cevaplamak |
| Güncel olaylar | Sınıflandırma ve etiketleme |
| Kesin API imzaları, sürüm numaraları | Taslak üretmek |
Sağdaki sütunun ortak özelliği dikkat çekicidir: cevabın malzemesi zaten prompt'un içindedir. Pratik önlem de buradan çıkar — modeli doğrulanabilir bir kaynağa bağlamak.
RAG: Cevabı Kendi Belgelerinizden Ürettirmek
RAG (Retrieval-Augmented Generation) yaklaşımı, soruyu doğrudan modele sormak yerine önce kendi belgelerinizde arar, bulduğu parçaları prompt'a ekler ve modelden yalnızca bunlara dayanarak cevap vermesini ister.
# RAG'ın tamamı dört adımdır
soru = "Yıllık izin devri kaç gün?"

# 1) Soruyu vektöre çevir
soru_vektoru = embed(soru)

# 2) En yakın belge parçalarını bul (embedding benzerliği)
parcalar = vektor_deposu.ara(soru_vektoru, adet=5)

# 3) Bulunanları prompt'a koy ve sınırı açıkça söyle
istem = f"""Aşağıdaki belge parçalarına DAYANARAK cevapla.
Cevap parçalarda yoksa "belgelerde bulamadım" de, tahmin etme.

--- BELGELER ---
{chr(10).join(parcalar)}

--- SORU ---
{soru}"""

# 4) Modele sor
cevap = model.uret(istem)
Bu yaklaşımın üç kazancı var: cevap güncel belgeye dayanır, kaynağı gösterilebilir, ve model bilmediğinde susmaya yönlendirilir. Fine-tuning'in aksine belge güncellendiğinde modeli yeniden eğitmeniz gerekmez — sadece dizini tazelersiniz.
İstemi Nasıl Yazmalı?
Modelin nasıl çalıştığını bilmek, istemi (prompt) yazarken doğrudan işe yarar. Model bir sonraki parçayı bağlama bakarak seçtiğine göre, istem aslında o bağlamı kurma işidir.
Üç kural, pratikte farkın büyük kısmını açıklar:
| Kural | Neden işe yarıyor |
|---|---|
| Rolü ve hedef okuru söyle | Bağlamı daraltır, üslubu belirler |
| Çıktının biçimini örnekle göster | Model biçimi de tahmin eder; örnek en güçlü ipucudur |
| Neyi yapmayacağını da yaz | "Bilmiyorsan söyle" demeden model susmayı seçmez |
Aynı işi isteyen iki istem arasındaki fark genellikle şudur:
Zayıf:
  "Bu logu incele."

Güçlü:
  "Aşağıdaki IIS erişim logunu inceleyen bir sistem yöneticisisin.
   Yalnızca 5xx dönen istekleri listele.
   Çıktı biçimi — her satır için tek satır:
     <saat> | <durum> | <yol> | <olası sebep>
   Sebebi logdan çıkaramıyorsan 'belirsiz' yaz, tahmin etme.

   --- LOG ---
   {log}"
Uzun istem her zaman iyi istem değildir: bağlama koyduğunuz her gereksiz cümle hem maliyeti artırır hem de attention'ı asıl işten uzaklaştırır. İyi istem uzun değil, belirsizliği az olandır.
Geliştirici İçin Ne Anlama Geliyor?
LLM'i sihirli bir kutu değil, olasılıksal bir bileşen olarak görmek doğru beklenti kurmayı sağlar. Kritik kararları doğrulamasız biçimde ona bırakmamak gerekir.
Tasarım aşamasında hesaba katılacak somut kısıtlar şunlardır:
| Kısıt | Pratik karşılığı |
|---|---|
| Bağlam sınırı | Uzun belgeler parçalanmalı, hepsi birden gönderilemez |
| Token maliyeti | Türkçede aynı içerik ~2 kat pahalı |
| Gecikme | Cevap token token üretilir; uzun cevap uzun bekleme |
| Belirsizlik | Aynı girdi her seferinde aynı çıktıyı vermeyebilir |
| Doğrulanabilirlik | Sayı ve kaynak içeren cevaplar kontrol edilmeli |
En sağlıklı kullanım, modeli bir taslak üreticisi ve hızlandırıcı olarak konumlandırıp son kontrolü insana bırakmaktır. Bu, modelin yeteneğini küçümsemek değil; nasıl çalıştığını bilerek kullanmaktır.
Daha fazlası: Yapay Zeka ve LLM serimizde bu kavramların her birini ayrı bölümlerde ele alıyoruz: token ve embedding'den transformer'a, RAG'dan prompt mühendisliğine kadar.
Videoyu sitemizde izle · YouTube'da aç · Kanala abone ol
Daha fazlası: Dil modellerinin bir sonraki kelimeyi nasıl tahmin ettiğini anlattığımız videoyla konuyu görsel olarak takip edebilirsiniz.
Videoyu sitemizde izle · YouTube'da aç · Bapati kanalına abone ol